

Terminal-Bench-Science(TBS)是一套用于评测 AI 模型的科学题库,也就是一个 Benchmark。TBS v0.1.0 将 70 道题目分为 20 个学科。化学部分只有两道题,都考察分子的三维形状及相关几何约束。这两道题能检验模型处理这类分子计算问题的能力。模型是否会分析化学实验或设计反应,还需要相应的题目来检验。
Science、Last Exam 这样的名称,可能让读者把高分理解为模型在整个领域里的水平。我们按研究内容检查了 TBS 的全部 70 道题目,查看各学科中哪些研究方向有题,哪些没有题。
本篇文章也有这个问题:起了一个很大的名字,但实际上只分析了一个典型的 Benchmark。大家固然有讲故事的需求,但我们希望你能通过这篇文章,看到一些更本质的东西。
TBS 的任务是为了难而难
根据我们的内部评估和了解,TBS 在构建过程中多次要求任务贡献者给题目加难,判断标准就是能否难倒当时最强的模型。但在项目推进期间,新模型不断发布,原本能难倒模型的题目一旦被新模型解出,就可能不再符合要求。维护者随后要求贡献者继续加难,之前投入的工作很可能要推倒重来,让不少贡献者疲于应付。我们认为,其中不少修改是在为了难而难,已经偏离了科学问题本身。不少任务的核心难点,在真实的科学发现中根本不会遇到。
学科内部存在大规模空白
TBS 一共有 20 个学科,每个学科都有题目。判断 TBS 在一个学科里考得是否全面,还要看题目具体涉及哪些研究方向。
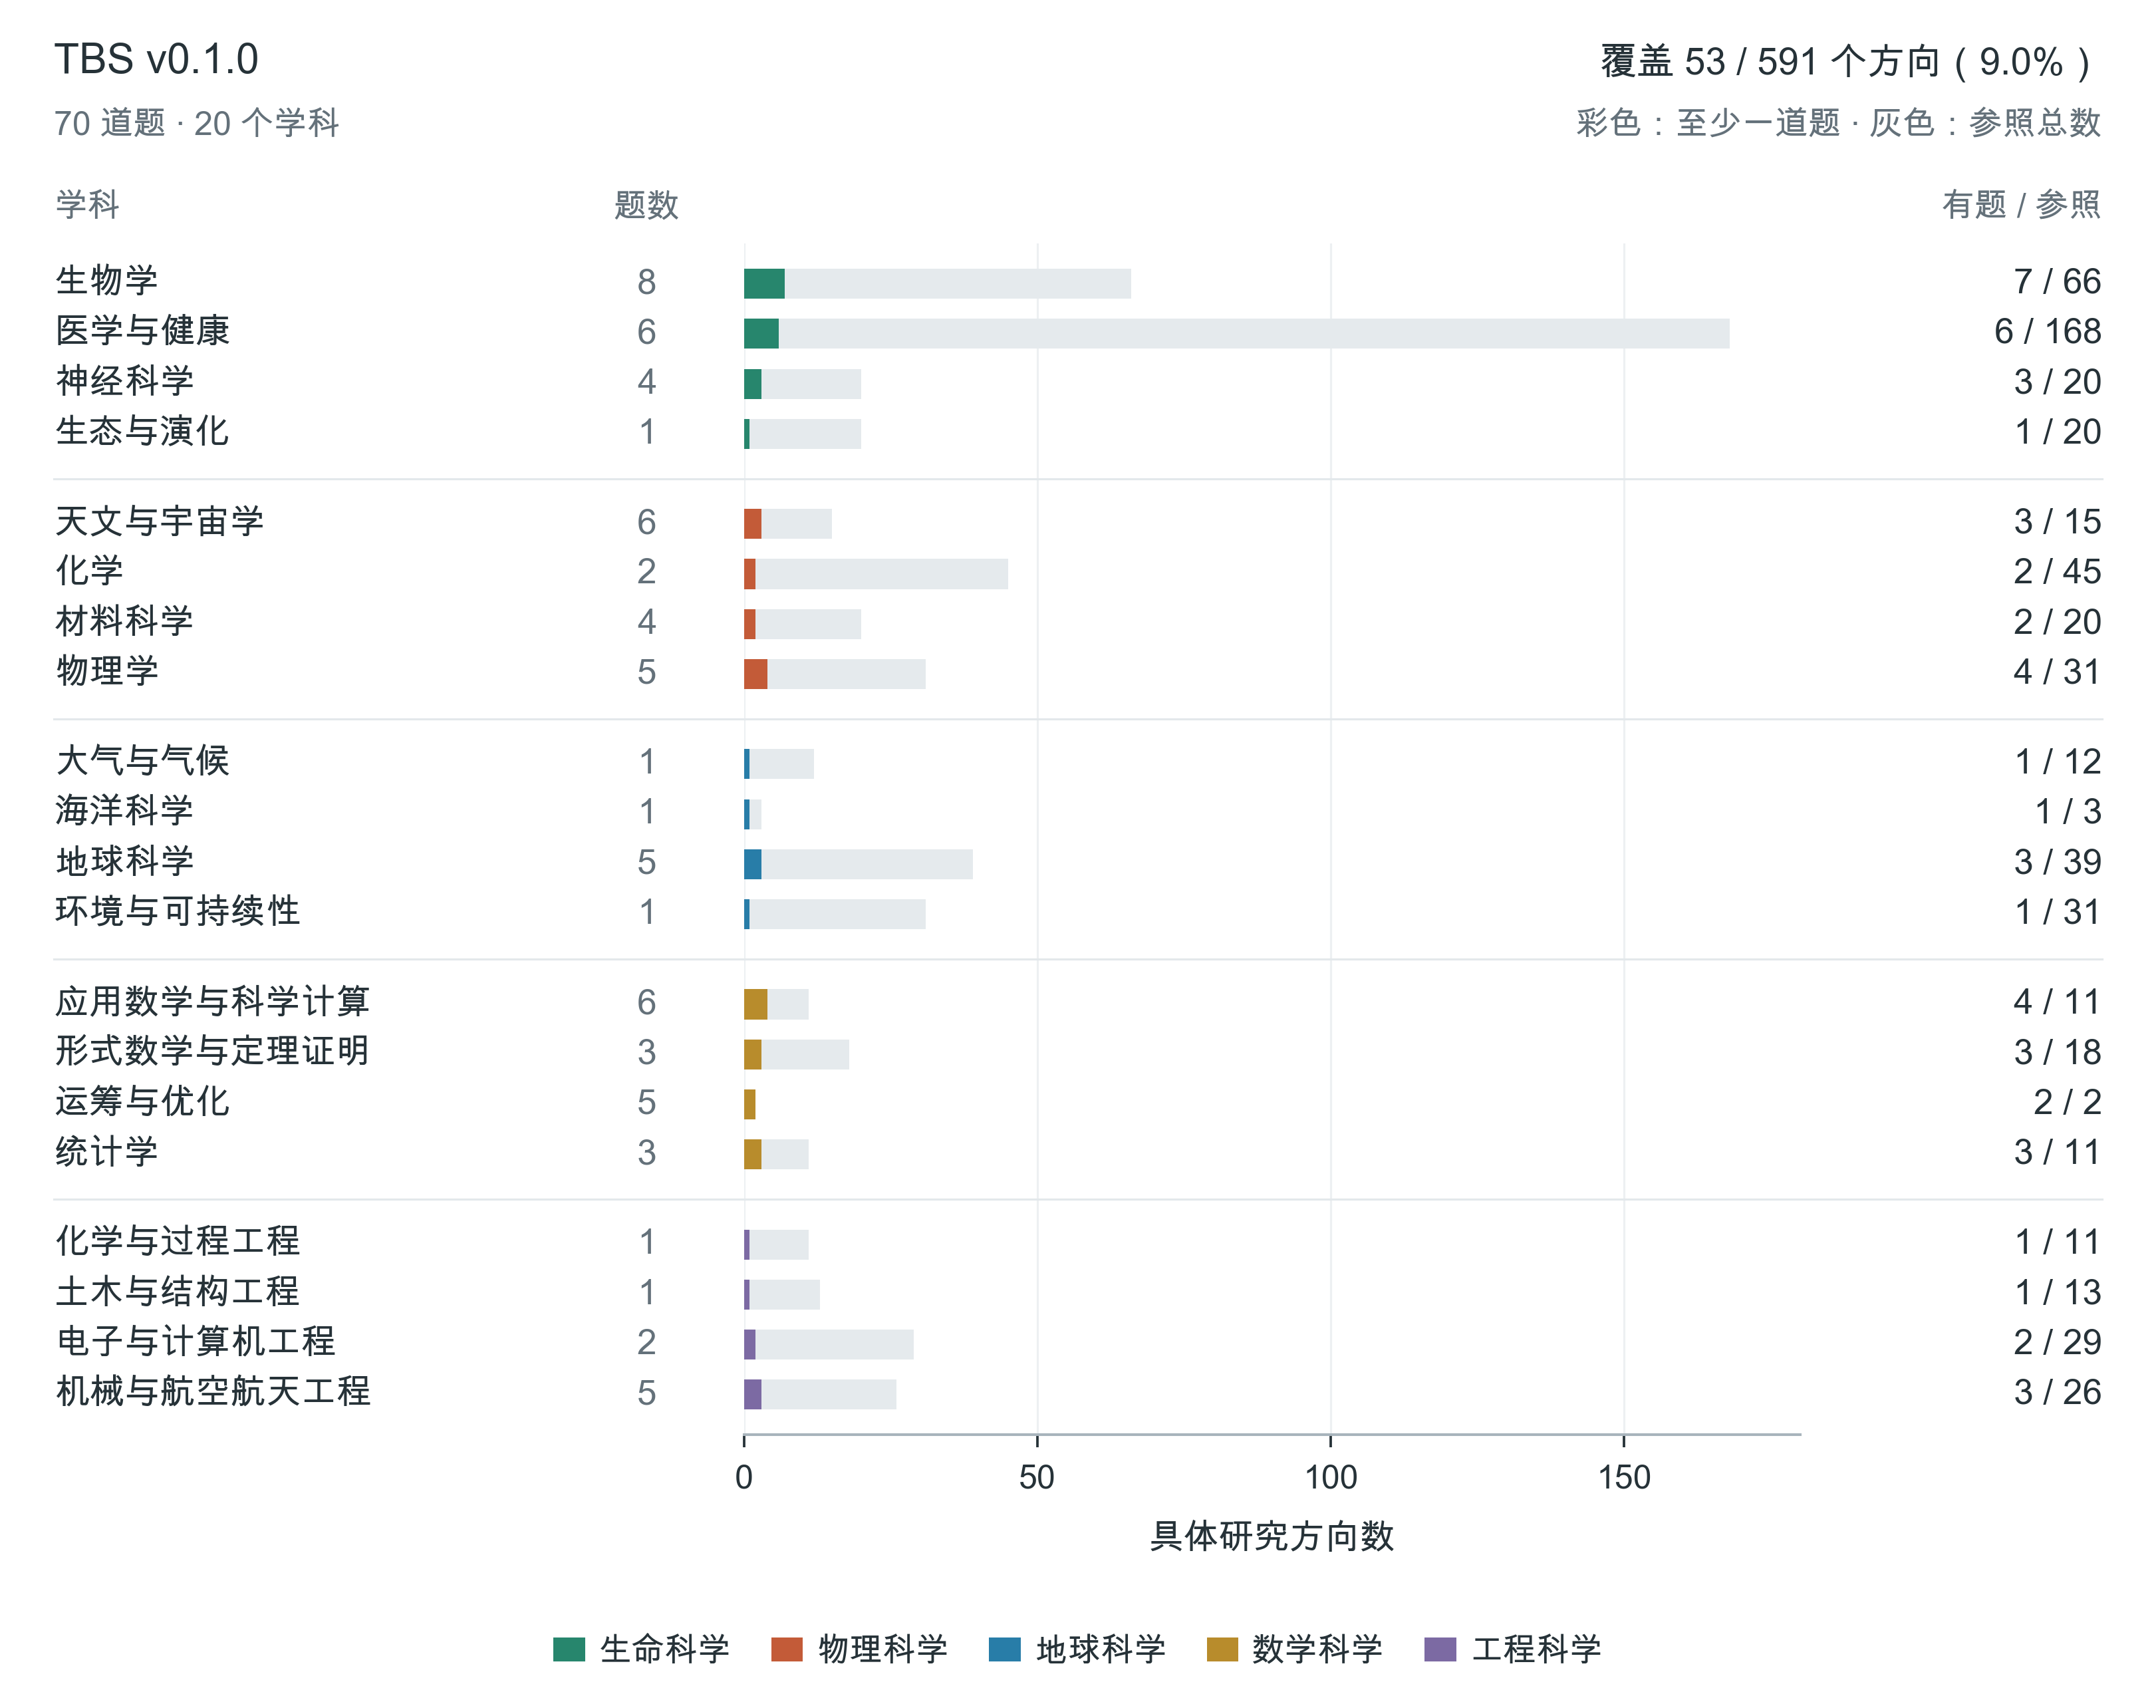
ANZSRC 是《澳大利亚与新西兰标准研究分类》的英文简称,其中的研究领域分类会把化学、生物学这样的大学科,进一步细分为更具体的研究方向。
我们从 ANZSRC 研究领域分类表中,为这 20 个学科选取了 591 个具体研究方向。每道题只归入它最主要的研究方向。一个方向只要有一道题,就计为已经覆盖。按这套规则,TBS 的题目涉及 53 个方向,覆盖比例约为 9.0%。591 个方向是本次分析的比较范围,TBS 并未承诺逐项出题。
图 1 中,各学科用于比较的方向数也不同。运筹与优化对应两个方向,医学与健康对应 168 个。覆盖比例受到这份分类表及所选范围的影响。仅凭百分比高低,无法判断 TBS 在哪个学科中考得更全面。
极少数题目难以代表整个学科
TBS 的 20 个学科里,有 8 个只有一至两道题,占 40%。其中六个学科各只有一道题。在这些学科中,评测提供的依据就是模型完成这一两道题的表现。
模型可能熟悉某道题采用的工具或数据,因而完成了这道题。更换数据、已知条件或求解目标后,模型是否仍能完成任务,需要新的题目来检验。即使原题很难,或者包含多个科研步骤,也不能替代这些测试。
题量限制了覆盖范围
TBS 题目涉及的 53 个具体研究方向中,有 41 个只有一道题,占 77.4%。
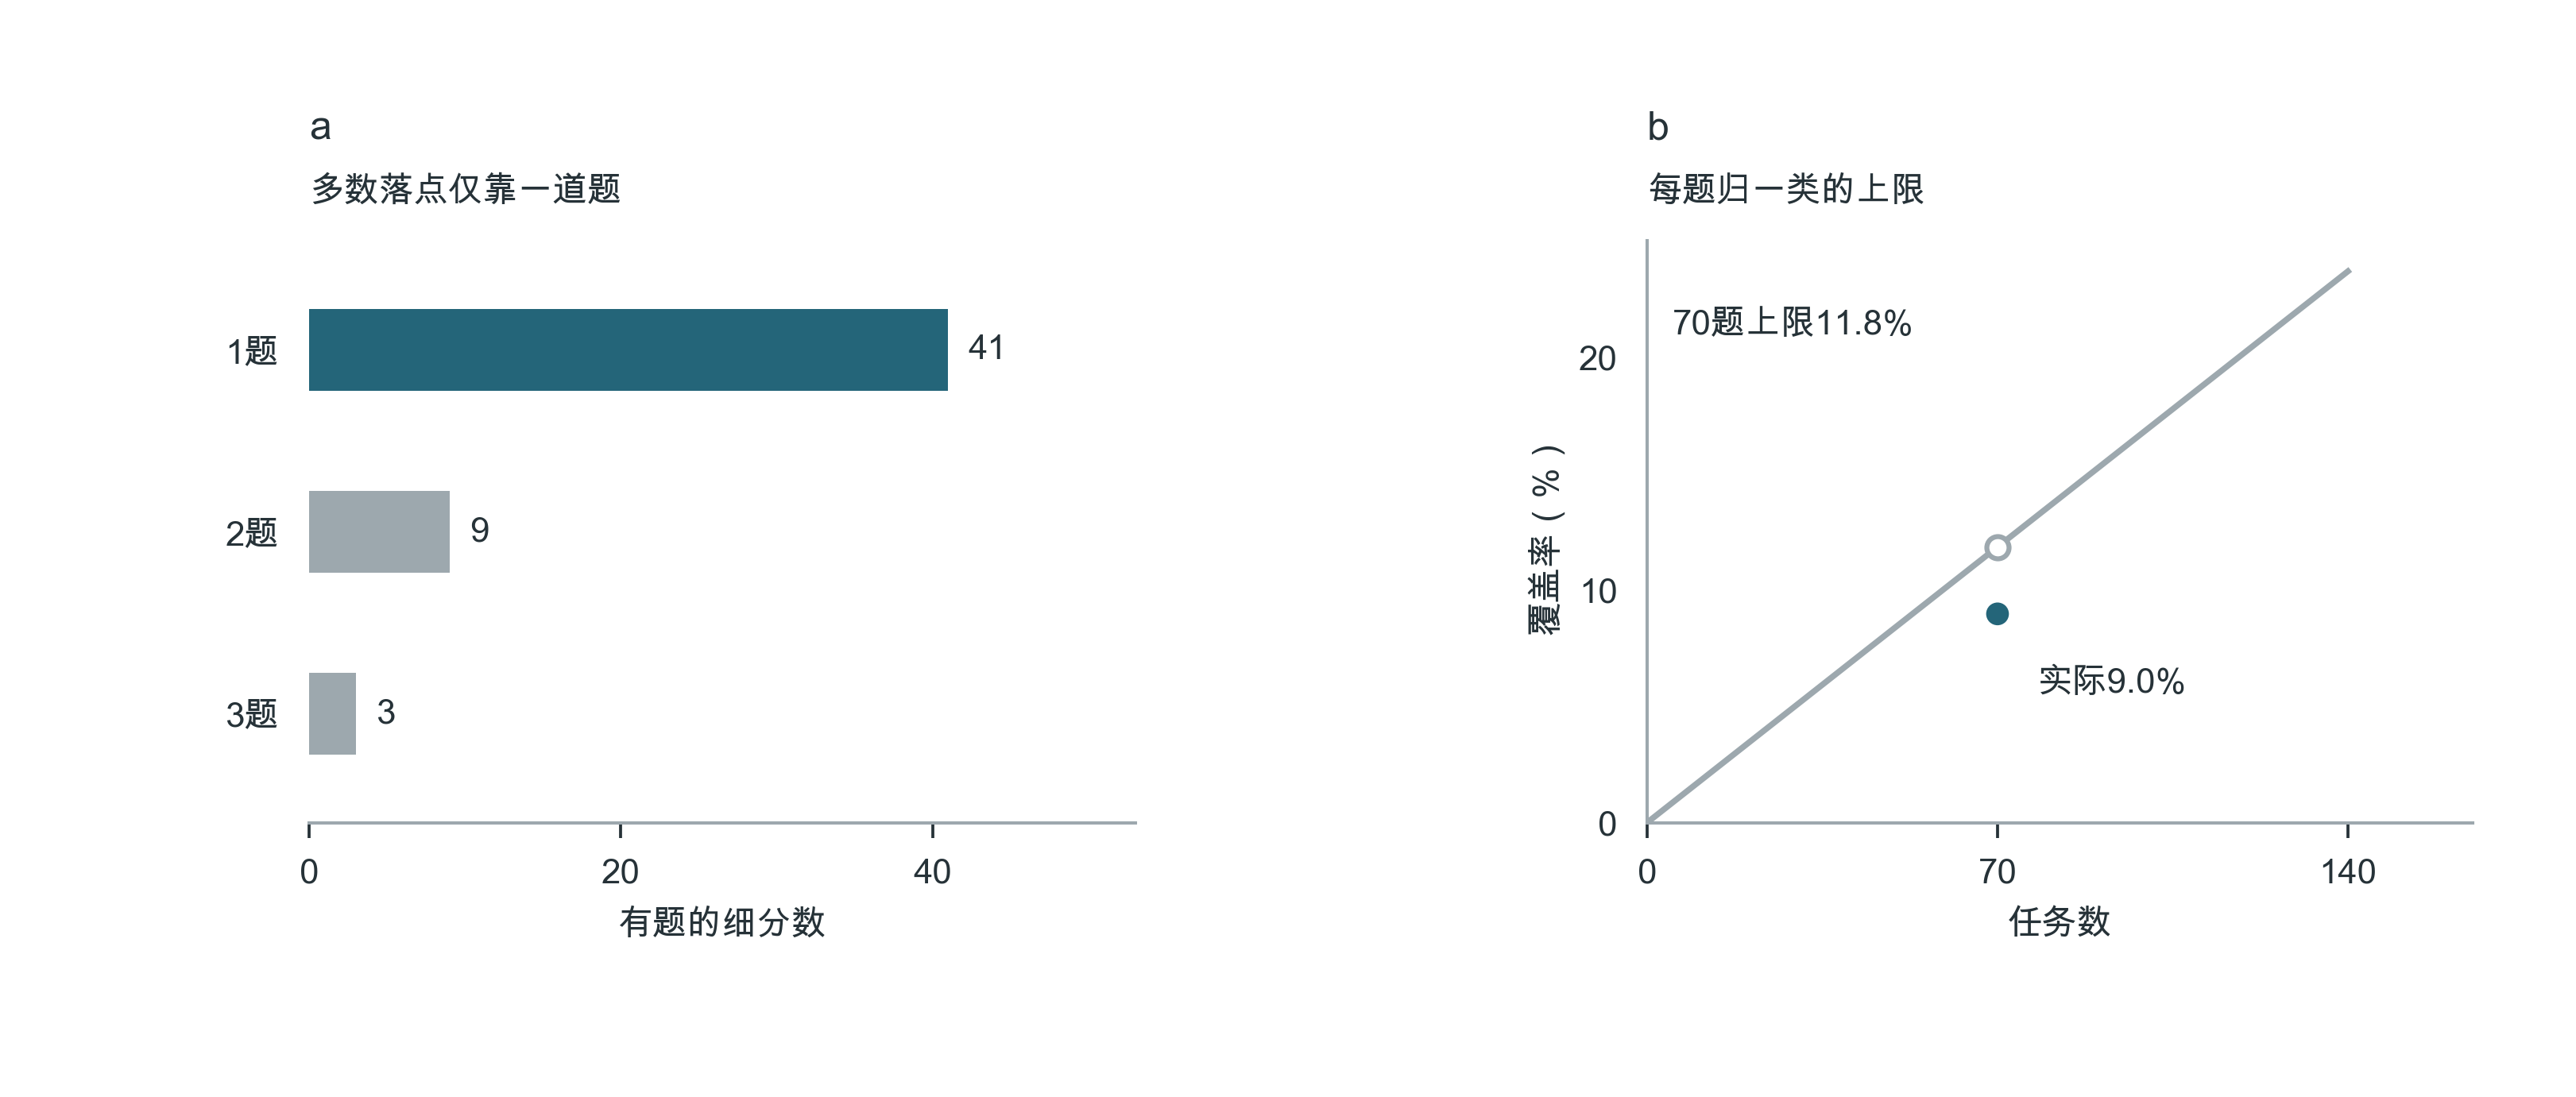
按每道题只计入一个主要研究方向的规则,70 道题最多涉及 70 个方向。即使每道题考察的方向都不同,覆盖所选 591 个方向的比例也只有 11.8%。因此,TBS 目前 9.0% 的覆盖比例,既受到选题的影响,也受到题目总量的限制。
解题流程偏向计算求解
学科标签丰富,并不自动带来解题流程的同等丰富。我们逐题检查了 TBS 全部 70 道任务的题面、官方参考解法和评分代码,分别整理了它们使用的工具和实际求解步骤。
在官方参考解法中,61 道包含 Python 计算,占 87.1%。其中有些还要配合其他语言或专业软件,三道依赖预先完成的人工标注或图像配准。题面明确要求提交 Python 程序、模块或复现脚本的有 22 道。Python 是这套题库最常用的计算工具。很多 TBS 的任务,本质上其实是软件工程。
按主要解题目标归类,23 道任务主要从数据中估计参数、识别模型或作统计推断,11 道主要做预测、分类或排序,10 道主要处理图像和信号。这三类合计 44 道,占 62.9%。它们通常从给定的数据和问题出发,要求模型建立计算方法,再提交参数、预测、图像或程序供评分。
机械工程中的三道导波损伤定位题利用沿结构传播的波寻找损伤。三题的参考解法先把传感器记录的波形与未损伤结构的记录或重建的参考信号比较,计算各条传播路径上的损伤指标。随后将这些指标合成为损伤位置图。三题分别用按公式构造的激励信号、未损伤结构的实验记录和结构仿真的结果作为参考。机械工程一共五道题,这组相近流程占了三道。
TBS 也有四道数学证明题,要求用证明工具 Lean 写出并检查推导。另外一些任务需要根据反馈继续行动。例如,蛋白主动学习题要求连续三轮选择实验对象,利用每轮返回的实验测量更新预测模型。
任务的质量备受质疑
我们的《Terminal-Bench-Science Review Report》逐题审查了 TBS v0.1.0 的 70 道任务。其中,34 道确认存在影响评测有效性的问题,5 道仍有具体疑点待核实,31 道在本轮审查中未发现实质缺陷。
这些问题会直接影响模型的成绩。例如,一道医学任务的两份原始病理记录写明“无炎症”,标准答案却标成“有炎症”。模型按原始记录答对,反而会被扣分。
外部公开检查也记录了任务缺陷。Horizon 检查了 28 道任务,其中 7 道因问题已有公开记录而未纳入新增统计。在其余 21 道中,它又发现 2 道会因题面未说明的行序或程序运行设置,把正确答案判成零分。
官方仓库的另一条公开问题记录指出,一道路径优化题的部分参考结果在进一步优化后反而变差。提交者指出,这可能影响正确解法的判分。
如果只计入我们报告中未发现实质缺陷的 31 道任务,涉及的学科会从 20 个减至 17 个,具体研究方向从 53 个减至 29 个。
分类结果可以指导训练与评测
这份子领域分类可以为训练数据配比提供参照。预训练让模型从大量文字、代码等材料中学习,开发者可以按子领域盘点这些材料,检查分布是否符合模型的目标用途。后训练通过有针对性的任务和反馈继续调整模型,开发者可以结合子领域和解题方式安排训练任务的比例。具体配比还要根据数据质量和训练后的表现调整。用于评测时,同一套分类还能帮助补充缺失题目、按子领域报告成绩,解释总分的变化来自哪里,也让研究者判断评测是否贴近自己的实际需求。
Conclusion
TBS 的 70 道题涉及 20 个学科,但在本次选定的分类范围内,题目只考察了少数具体研究方向,而且多数方向只有一道题。解题活动也偏向计算求解,部分任务采用相近的流程。
在评分可靠的前提下,TBS 的高分说明模型在这组任务上表现好。要把这一成绩推广为模型在整个科学领域的能力,还需要检验模型能否处理题库之外的研究内容和工作方式。
Reference
[1] Terminal-Bench-Science v0.1.0 发布清单及任务说明,版本标识 f81afac。任务数量、官方学科标签及任务内容据此整理。
[2] 本分析的 70 题逐题分类与计数;参照为澳大利亚与新西兰标准研究分类 ANZSRC 2020 的研究领域分类,采用 2025 年 10 月 24 日修订表。每题一个主分类,排除“未另分类”这类无法继续细分的兜底项。53/591、77.4% 及参照口径比较均为本分析结果,不是 TBS 官方发布的覆盖率。
[3] Benchmarks’ Last Exam《Terminal-Bench-Science Review Report》,2026 年 10 月 22 日,2026 年 11 月 3 日更新。审查版本:f81afac。
[4] Benchmarks’ Last Exam,TBS v0.1.0 全部 70 题的解题方法审读,2026 年 11 月 10 日,版本标识 f81afac。工具统计依据官方参考解法,交付要求依据题面。每题按主要目标计入一个方法分组。
[5] Horizon,《Preliminary Data Quality Index》,Terminal-Bench Science 条目,2026 年 11 月 10 日查阅。
[6] GitHub 用户 afterquery-official,Terminal-Bench-Science 官方仓库 energy-routing 问题记录 Issue #2709,2026 年 11 月 8 日。
[7] Xie 等,《DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining》,NeurIPS 2023。
[8] Lambert 等,《Tulu 3: Pushing Frontiers in Open Language Model Post-Training》,2024,arXiv:2411.15124。