

FrontierPhysics 以 56 个物理研究任务考察 AI 独立开展科研的能力,下文简称 FP。模型需要检索文献、编写代码、处理数据,最终提交计算结果和一篇论文。
评分分为两部分。检查程序将模型的计算结果与出题者的参考值比对。另一个 AI 评审阅读模型的代码、操作记录和论文,依照出题者编写的评分规则逐项打分。评分规则中设有一票否决项,任何一项未通过,整次作答即判为失败。
每个模型对每道题作答三次,共 168 次。表现最好的 Claude Opus 5.5 通过 46 次,通过率为 27.4%。
本文依据 FP 论文、官网示例和公开开发版代码,探讨这套评测中五处不尽合理的设计,以及它们对分数含义的影响:部分题目的评分限定了方法,参考结论缺少公开的独立验证,一票否决放大了误判,评分误差在不同模型之间可能并不均匀,模型可能提前接触过答案。FP 团队自己的复核已经发现了这类问题的实例:复核 GPT-6 Astra 的作答时,有 9 次失败应改判为通过,原因在于题目、检查程序和评分。开发版是出题者编写和调试任务时公开的题目与评分代码,其与正式榜单所用版本是否一致,目前尚未确认。
评分规则限定了解题方法
FP 论文将不预先规定解题方法列为设计原则。公开开发版中的激光噪声任务与这一原则存在出入。
利用激光操控原子进行量子计算时,激光频率的微小抖动会导致量子操作出错。该任务提供四份实测噪声数据,要求模型计算抖动造成的误差,并绘制误差随激光驱动强度变化的曲线。题面未指定计算方法。
这一误差至少有两种算法。第一种先计算量子操作对各频率抖动的敏感度,再与实测噪声逐频率相乘并累加。第二种在计算机中反复生成随机抖动,模拟其影响后取平均。两种做法在物理上均成立。
评分规则仅认可第一种,并将其设为一票否决项。模型若采用随机模拟,而未说明它与第一种算法的联系,即使数值检查通过,整次作答仍判为失败。
相比之下,数值检查允许合理分歧。噪声数据仅测至 8 MHz,出题者分别假设更高频率的噪声归零和保持不变,得到两条误差曲线。模型的结果落在两条曲线之间,并留有一定余量,即可通过。数值检查接受不同假设,方法评分却只认可一种路径。若评分规则写明其他算法满足哪些条件即可通过,将更符合 FP 的设计原则。
参考结论有待独立验证
FP 的参考答案由出题研究者提供。56 个任务中,18 个来自已发表研究,其中 4 个发表于 Nature。发表记录并不等同于结论经过了独立验证。
FP 开展了两类检查。第一类是领域同行审查,由研究方向相近的研究者审阅题目,判断题目是否过多提示解法、评分规则是否考查所需的物理知识,并从模型试做记录中找出题意不清和误判之处。第二类是将 33 个任务所附的原研究论文或手稿交给 AI 评审,仅按稿件本身可以判断的要求评分,平均得分为满分的 96.2%。这表明评分规则与原作者的材料相吻合。
两类检查的对象都是题目和评分规则,并未检验原研究的结论是否成立。检验结论需要其他研究者重新计算、分析数据或重复实验。FP 论文未报告覆盖全部任务的此类验证。
对于按给定方程和参数求值的题目,参考数值可以直接核对,影响相对有限。对于判断数据是否支持某一发现的题目,情况则有所不同。假设模型在截取某段数据时观察到一种效应,换用另一段同样合理的范围后效应消失,那么指出结论依赖数据范围本身即是研究成果。评分若只接受预期发现,此类严谨的质疑可能被判为错误。FP 若能说明每道题的参考结论经过了哪些检查,以及模型未发现预期效应或发现反证时如何评分,评分依据将更加清晰。
一票否决会放大误判
一票否决项会将单项错误放大为整次失败。题目存在歧义、检查程序出错或 AI 评审遗漏证据,都可能使正确的作答被判为失败。
FP 团队与出题者逐一复核了 GPT-6 Astra 在 xhigh 推理强度下的 168 次作答。推理强度越高,模型作答时投入的思考计算越多。复核发现 9 次失败应改判为通过,其中 8 次源于题目、检查程序或评分规则,1 次源于 AI 评审误判。
论文给出了两个例子。晶格几何任务的一次作答已得到正确数值,但由于题目规定的计算规模过大,程序运行报错。中子星任务的一次作答被扣分,原因是题目未说明分析前应如何设定参数的先验,即参数的可能取值及其概率。
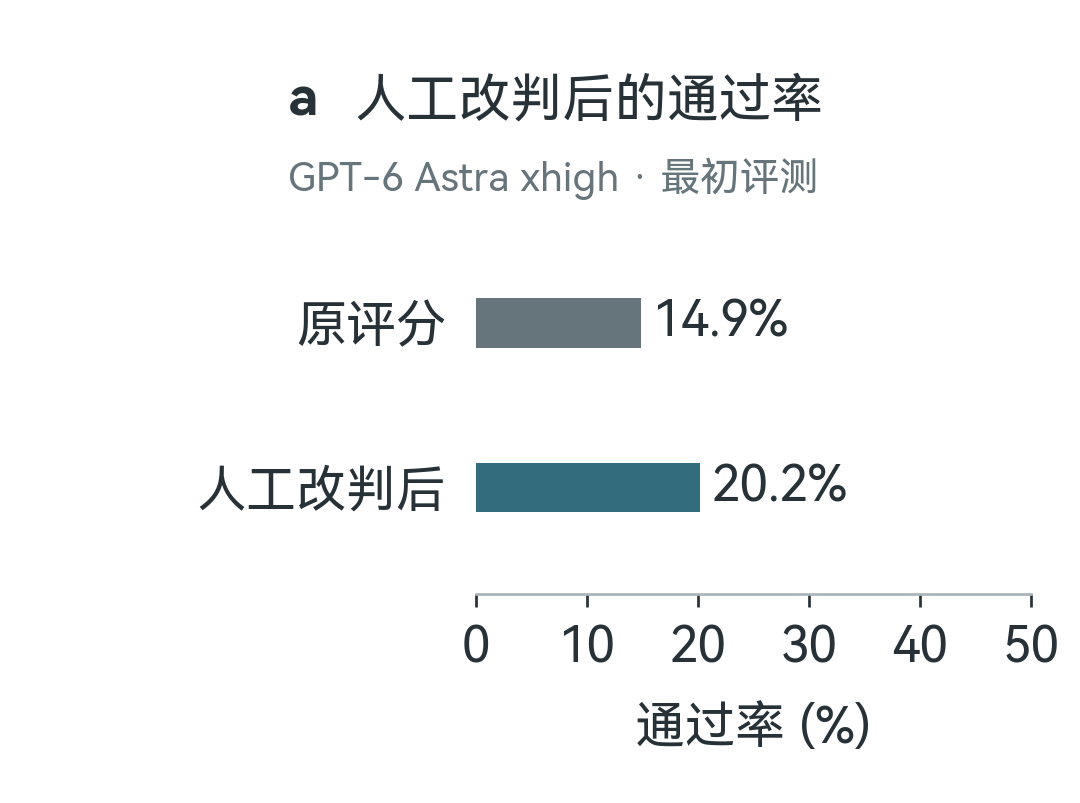
改判后,同一批作答的通过次数由 25 次增至 34 次,通过率由 14.9% 升至 20.2%,见图 1a。FP 团队随后修复相关任务,让模型重新作答或重新评分,最终表格中该设置的通过率为 19.6%。20.2% 是在原作答上直接改判的结果,19.6% 是修复任务后重新得到的结果。分析模型欠缺哪些科研能力,需要先排除此类误判。
评分误差在不同模型之间可能并不均匀
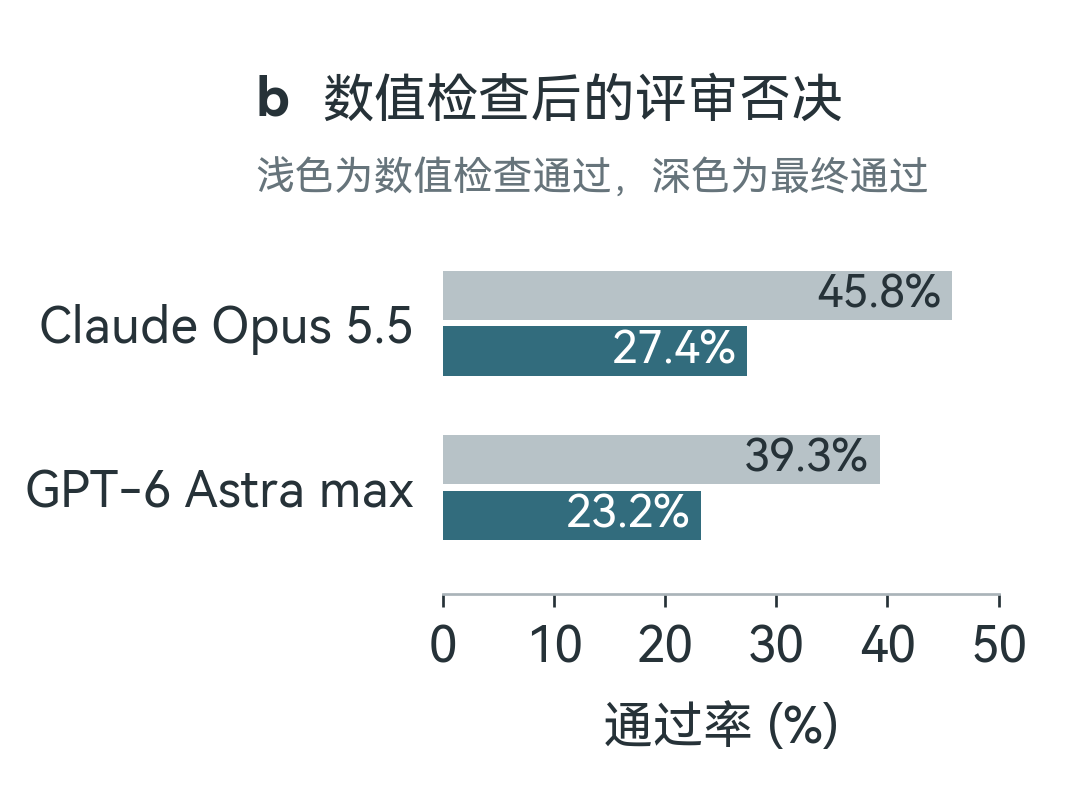
数值检查之后,AI 评审的裁决对结果影响很大。按论文主表的通过率换算,Opus 5.5 有 77 次作答通过数值检查,其中 31 次未能通过一票否决项,约占 40%。GPT-6 Astra 在 max 推理强度下为 66 次中的 27 次,比例相近,见图 1b。这些作答中既有真实的科研缺陷,也可能包含误判,需要逐次核查才能区分。
FP 所有结果由同一个 AI 评审给出,即 GPT-5.6 Sol。论文另用 Claude Opus 5.5 担任评审,重评了首轮作答。对 GPT-6 Astra 的作答,两位评审在 53 次通过数值检查的作答中,有 48 次结论一致,通过数分别为 25 次和 26 次。对 Opus 5.5 自己的作答,一致的为 67 次中的 58 次,通过数从默认评审的 37 次增至 44 次,其中 Opus 评审单独放行 8 次,默认评审只放行 1 次。论文据此指出,Opus 5.5 评审对同系列模型的作答更宽松。重评只做了这两个模型,其余配置没有换评审复核。
误判复核的范围同样有限。论文说明,其他模型与工具的组合可能以分类之外的方式失败,因此只能准确标注并校正 GPT-6 Astra 的误判。其余配置的通过率中含有多少误判,论文未给出估计。榜单上各模型的分数因此可能含有不同程度的评测误差。
模型可能在训练中接触过答案
激光噪声任务的评分规则写明,出题者的博士论文可公开获取,其中包含完整解答。出题者公开的项目代码中另有 4 个开发版任务,名称与正式任务清单中的题目相同,并附有参考答案和评分规则。
FP 的防范措施针对作答过程。官网示例注明会屏蔽一批网址。激光噪声任务的开发版允许联网,但评分时会检查模型是否检索并照搬原作者论文中的结果。若模型在训练阶段已读到这些解答,作答时无需检索,也可能依靠记忆完成。因此,作答记录中没有查阅答案的痕迹,尚不足以证明结果由模型独立推导。
结论
上述五处设计使 27.4% 的含义变得复杂。它对应的是模型在这 56 道题、这套评分规则和这位 AI 评审下的表现,与独立科研能力之间尚有距离。更值得关注的是失败的具体原因。FP 论文为 GPT-6 Astra xhigh 原评分中的 143 次失败逐一标注了原因,其中也单独列出了误判。一次失败可对应多个标签,出现最多的是推理不够严谨,占 48%,其次是缺乏专家直觉,占 34%,以及文献使用错误,占 27%。相比总分和名次,这些标签更能说明模型在科研中的薄弱环节。
参考资料
[1] FrontierPhysics 论文 v1,2026 年 11 月 4 日。任务与评分规则见第 2 节,作者参考材料的评分见第 3.3 节,审计、修复与失败分类见第 3 节及图 6,主表通过率见表 2,换评审重评见附录表 6。
[2] 公开开发任务及评分代码,固定提交 2f3ec886。方法限制及答案暴露的代码证据来自该版本。
[3] FrontierPhysics 官网,示例任务、网络设置和榜单,2026 年 11 月 10 日查阅。